Anthropic이 Claude Code의 시스템 프롬프트에서 80% 이상을 지웠다. 그런데 코딩 평가 지표에서 성능 저하가 측정되지 않았다.
배경
내 CLAUDE.md는 짧은 편이다. 길어야 50줄이고 상세한 건 별도 규칙 파일로 빼뒀다. 그래서 이쪽은 신경 안 써도 되는 줄 알았다.
프론트와 백엔드를 각각 다른 레포로 두는 프로젝트가 있다. 두 CLAUDE.md의 "작업 원칙" 섹션이 글자 하나 안 틀리고 같았다. 복사해 붙인 것이다. 그 안에 이런 문장이 있었다.
최소한
yarn workspace @app/client lint통과를 완료 기준으로 삼는다.
백엔드 레포에서 돌려 봤다.
백엔드는 모노레포가 아니다. 워크스페이스 설정이 없으니 될 리가 없다. 게다가 백엔드에도 공교롭게 같은 이름의 패키지가 있는데, 그쪽은 Vue고 프론트 것은 React다. 이름이 겹치는 바람에 눈으로 읽을 때는 멀쩡해 보였다.
파일이 짧은 것과 파일이 맞는 것은 다른 문제였다.
그러던 참에 Anthropic이 정반대 방향의 결과를 내놨다. 지침을 더 준 게 아니라 지웠는데 성능이 유지됐다는 것이다.
We removed over 80% of Claude Code's system prompt for models like Claude Opus 5 and Claude Fable 5 with no measurable loss on our coding evaluations.
출처: The new rules of context engineering for Claude 5 generation models (Anthropic, 2026-07-24, Thariq Shihipar)
이 글은 원문을 읽고 요점을 재구성한 정리 노트다. 원문에 없는 내 판단이 들어간 대목은 그렇다고 밝혀 뒀다.
이 글이 답하려는 질문: 규칙을 80% 지웠는데 왜 성능이 떨어지지 않았나?
문제는 규칙이 모자란 게 아니었다
원문의 진단은 짧다. 모델을 과하게 제약(overconstrain) 하고 있었다는 것이다.
한 번의 요청 안에서 지침끼리 부딪히는 일이 흔했다. 시스템 프롬프트는 A를, 스킬 파일은 B를 시키고, 정작 사용자는 C를 요청한다. 이때 모델은 문제를 푸는 대신 누구 말을 들을지 고른다.
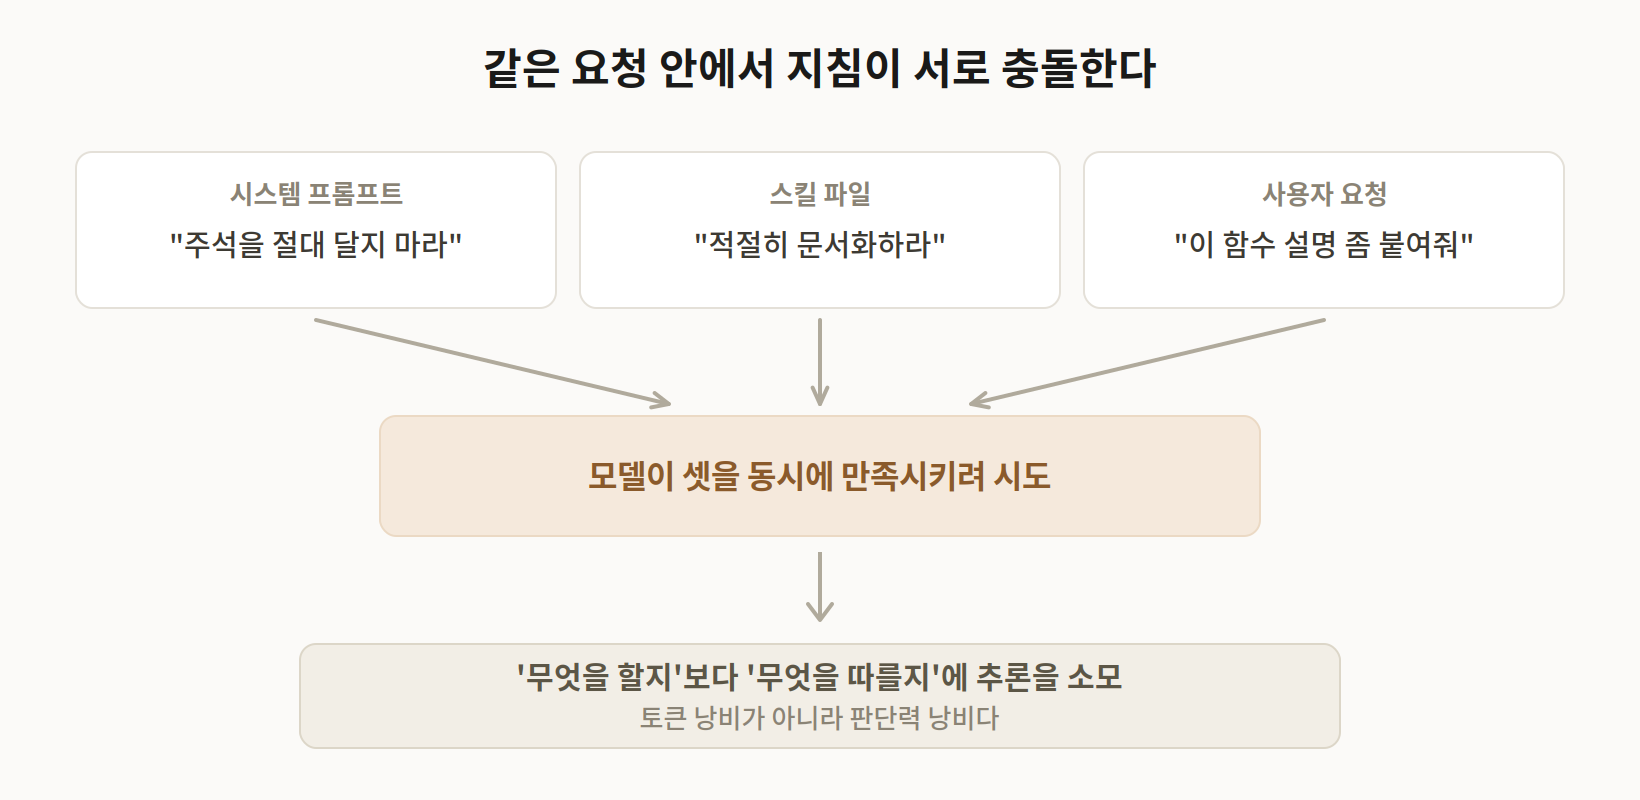
판단에 써야 할 추론이 지침 해석에 새어 나간다. 규칙을 늘려도 결과가 나아지지 않는 이유가 여기 있다.
가드레일이 값어치를 하던 시절은 분명히 있었다. 달라진 건 모델 쪽이다. 신입 첫 주에 "금요일엔 배포 금지"는 사람을 살리지만, 3년차에게 같은 매뉴얼을 들이밀면 일을 방해한다.
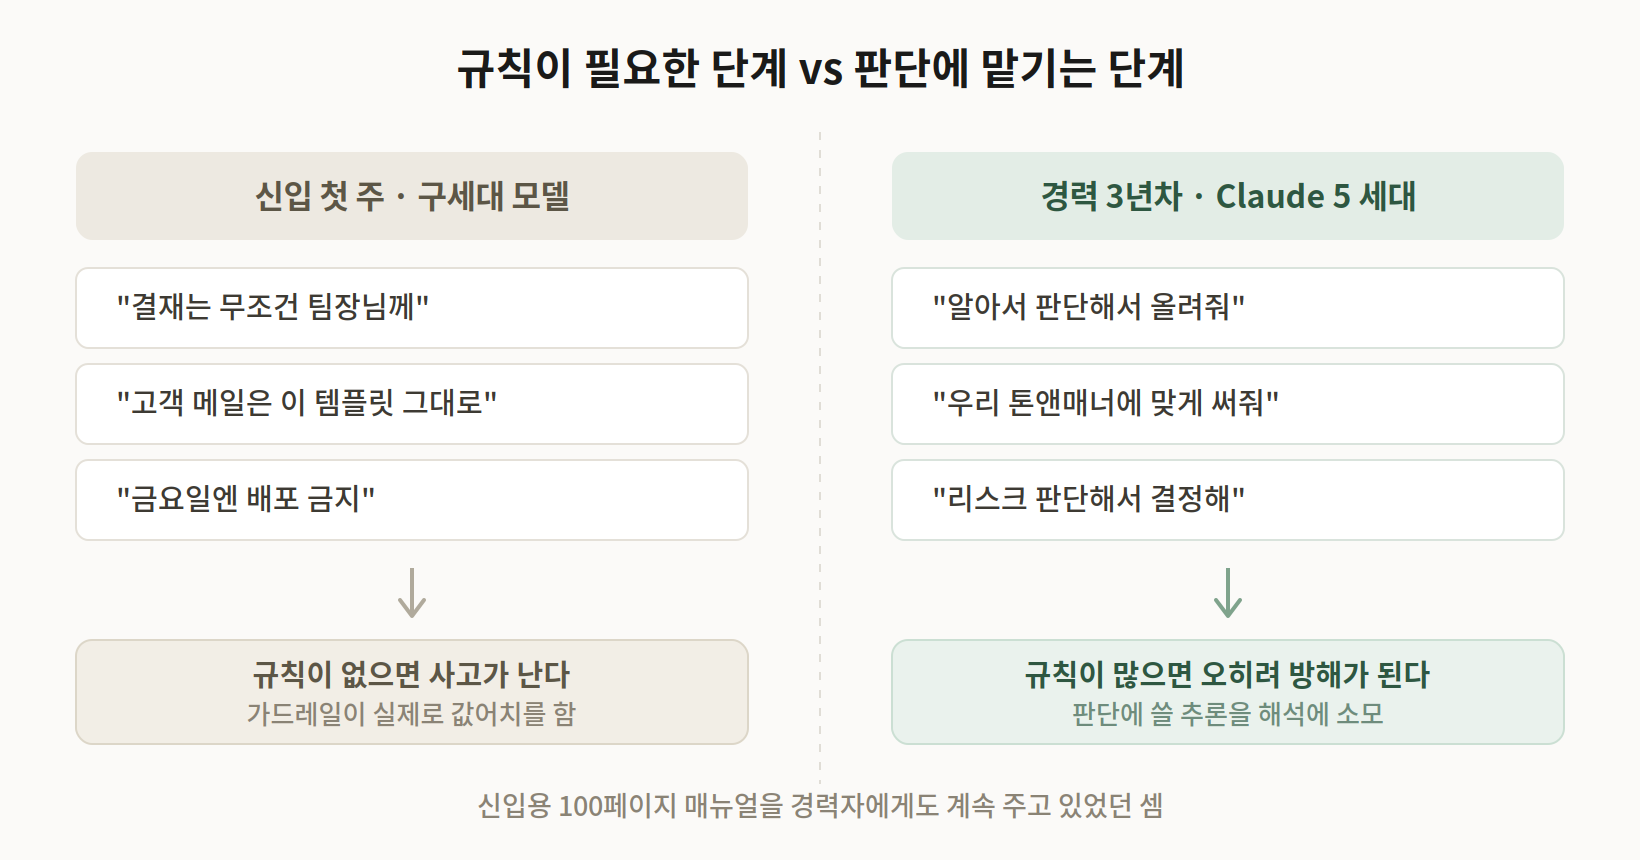
3년차에게 필요한 건 매뉴얼이 아니라 "저기 지뢰가 하나 묻혀 있다"는 정보다.
프롬프트와 컨텍스트는 다른 문제다
| 구분 | 프롬프트 | 컨텍스트 |
|---|---|---|
| 범위 | 1회 요청 | 다수 요청에 공통 적용 |
| 구체성 | 구체적으로 쓸 수 있음 | 구체적으로 쓸 수 없음 |
| 구성 요소 | 사용자 메시지 | 시스템 프롬프트, 스킬, CLAUDE.md, 메모리, 레퍼런스 |
프롬프트는 이번 한 번을 위해 쓰니 마음껏 구체적일 수 있다. 컨텍스트는 앞으로 들어올 모든 요청에 적용되는데 그 요청이 뭘지 미리 알 수 없다. 구체적으로 쓰면 어딘가에서 반드시 틀리고, 뭉뚱그려 쓰면 아무 도움이 안 된다. 컨텍스트 엔지니어링이 어려운 건 글솜씨가 아니라 이 구조 때문이다.
폐기된 6가지 통념
| # | Then | Now |
|---|---|---|
| 1 | 규칙을 명시하라 | 판단에 맡겨라 |
| 2 | 사용 예시를 줘라 | 인터페이스를 설계하라 |
| 3 | 전부 앞에 넣어라 | 점진적 공개 |
| 4 | 중요한 건 반복하라 | 도구 설명을 간결하게 |
| 5 | CLAUDE.md에 메모리 저장 | 자동 메모리 |
| 6 | 단순한 스펙 문서 | 풍부한 레퍼런스 |
1) 규칙 → 판단
원문이 사례로 든 게 주석 규칙이다. 예전 지침은 이랬다.
In code: default to writing no comments. Never write multi-paragraph docstrings or multi-line comment blocks — one short line max.
지금은 이렇게 바뀌었다.
Write code that reads like the surrounding code: match its comment density, naming, and idiom.
금지어를 걷어내고 기준을 하나 준 것이다. 몇 줄까지 되는지 세는 대신 어디를 보고 맞추라고 가리킨다. 강한 금지어에는 반드시 틀리는 경우가 생기지만, 기준은 상황에 맞춰 따라온다.
2) 예시 → 인터페이스 설계
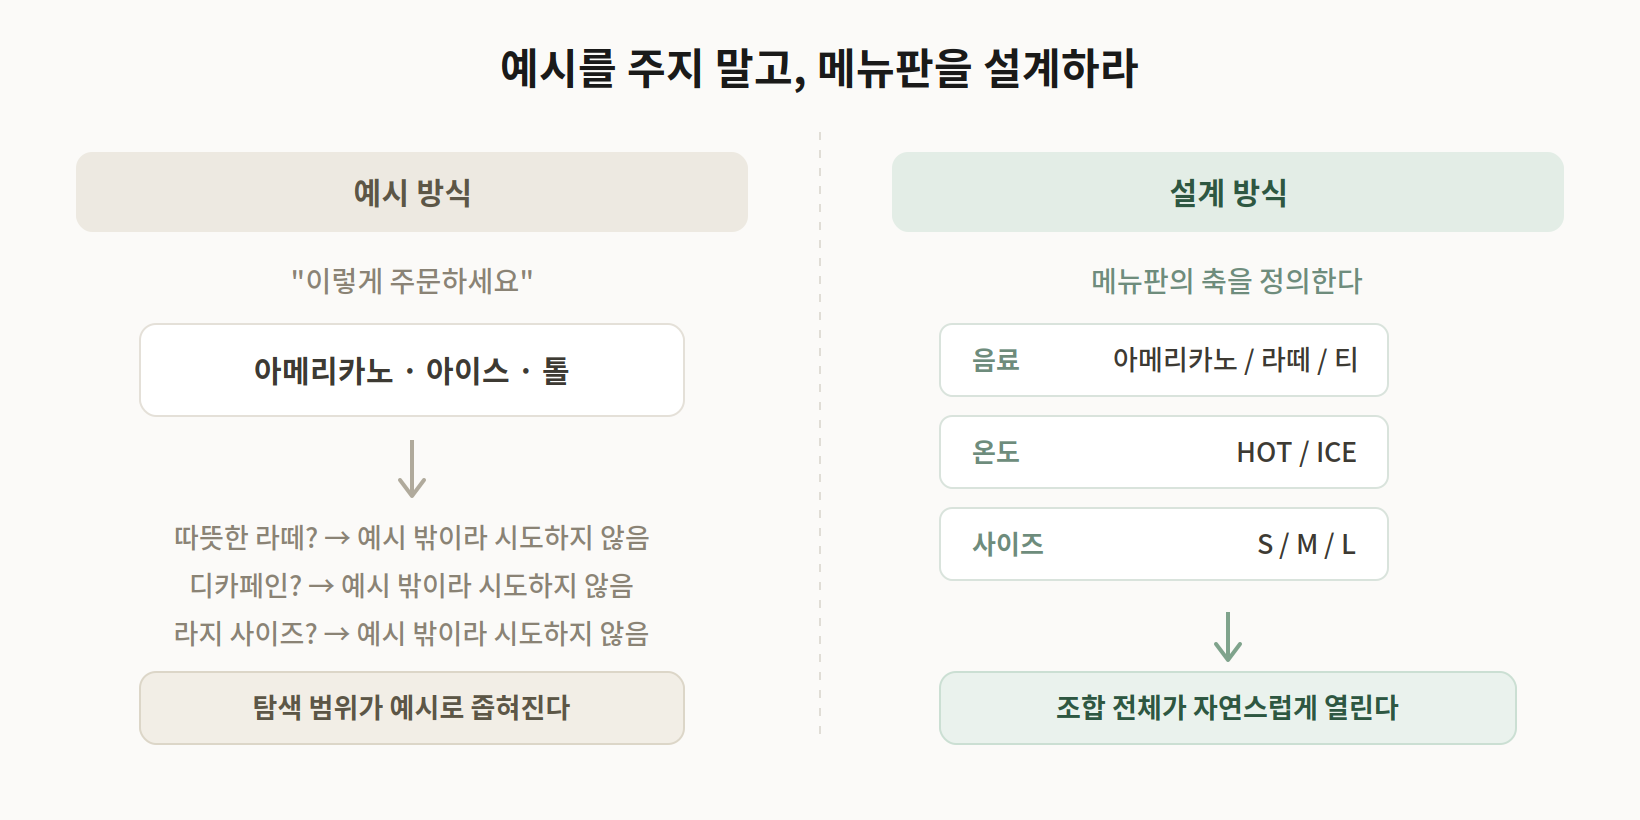
이 항목이 제일 뜻밖이었다. "예시를 줘라"는 오랫동안 도구 사용법 1순위 규칙이었는데, 최신 모델에서는 예시가 탐색 공간을 되레 좁힌다는 것이다.
대신 도구의 설계에 시간을 쓴다. 원문이 든 예가 Todo 도구다. status를 pending·in_progress·completed 세 값으로 못 박으면 열거형 자체가 사용법을 설명한다. 여기에 "in_progress는 하나만 유지"를 더하면 원하는 동작까지 규정된다. 사용 예시를 쓸 자리가 없다.
def process(data, flag, mode):
"""flag가 True면 검증을 수행하고, mode는 1이면 빠르게,
2면 정확하게, 3이면 둘 다... (설명 계속)"""
# ✅ 시그니처만 봐도 사용법이 드러난다
def validate_orders(
orders: list[Order],
strictness: Literal["fast", "accurate"] = "fast",
skip_expired: bool = False,
) -> ValidationReport:
타입과 이름이 이미 다 말하고 있어서 설명서가 필요 없다.
3) 전부 앞에 → 점진적 공개
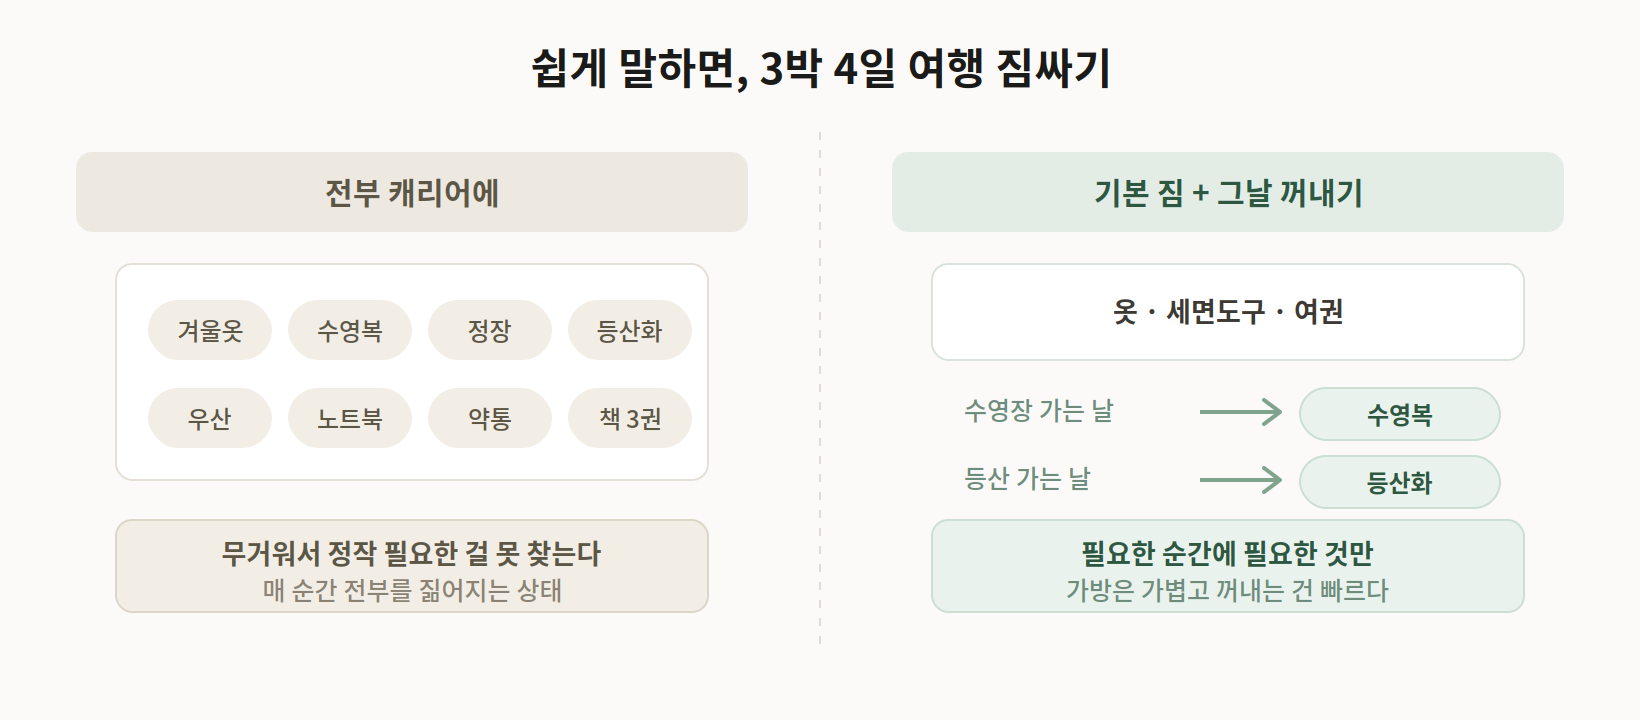
"CLAUDE.md에 다 넣어야 Claude가 찾는다." 흔한 오해고 사실이 아니다. 도구에는 지연 로딩이 걸려서 백 개를 붙여놔도 쓰지 않으면 컨텍스트를 먹지 않는다.
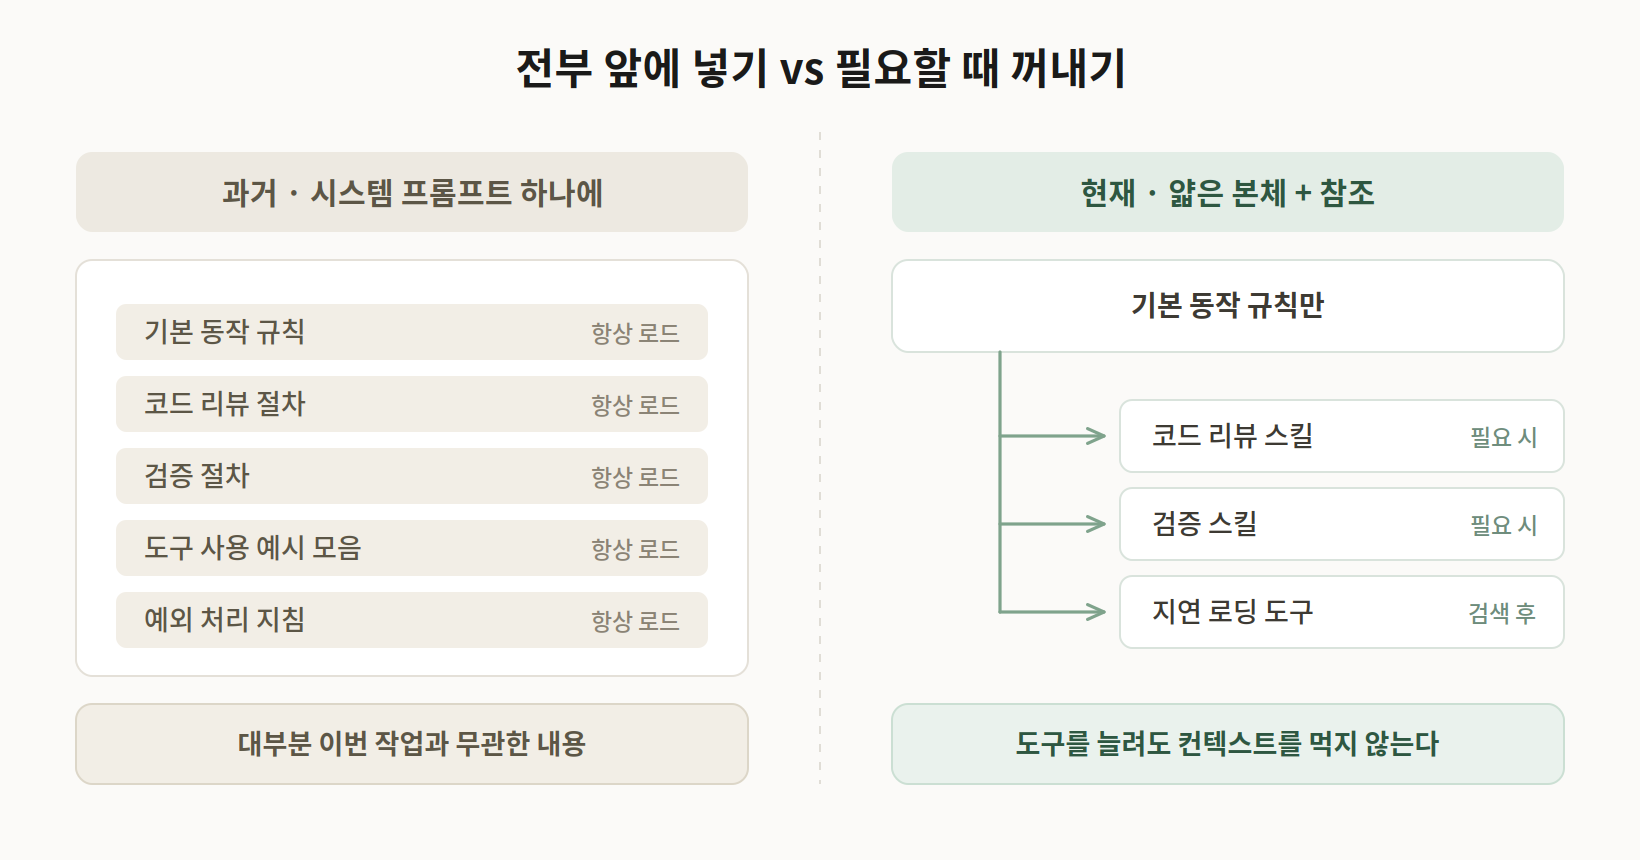
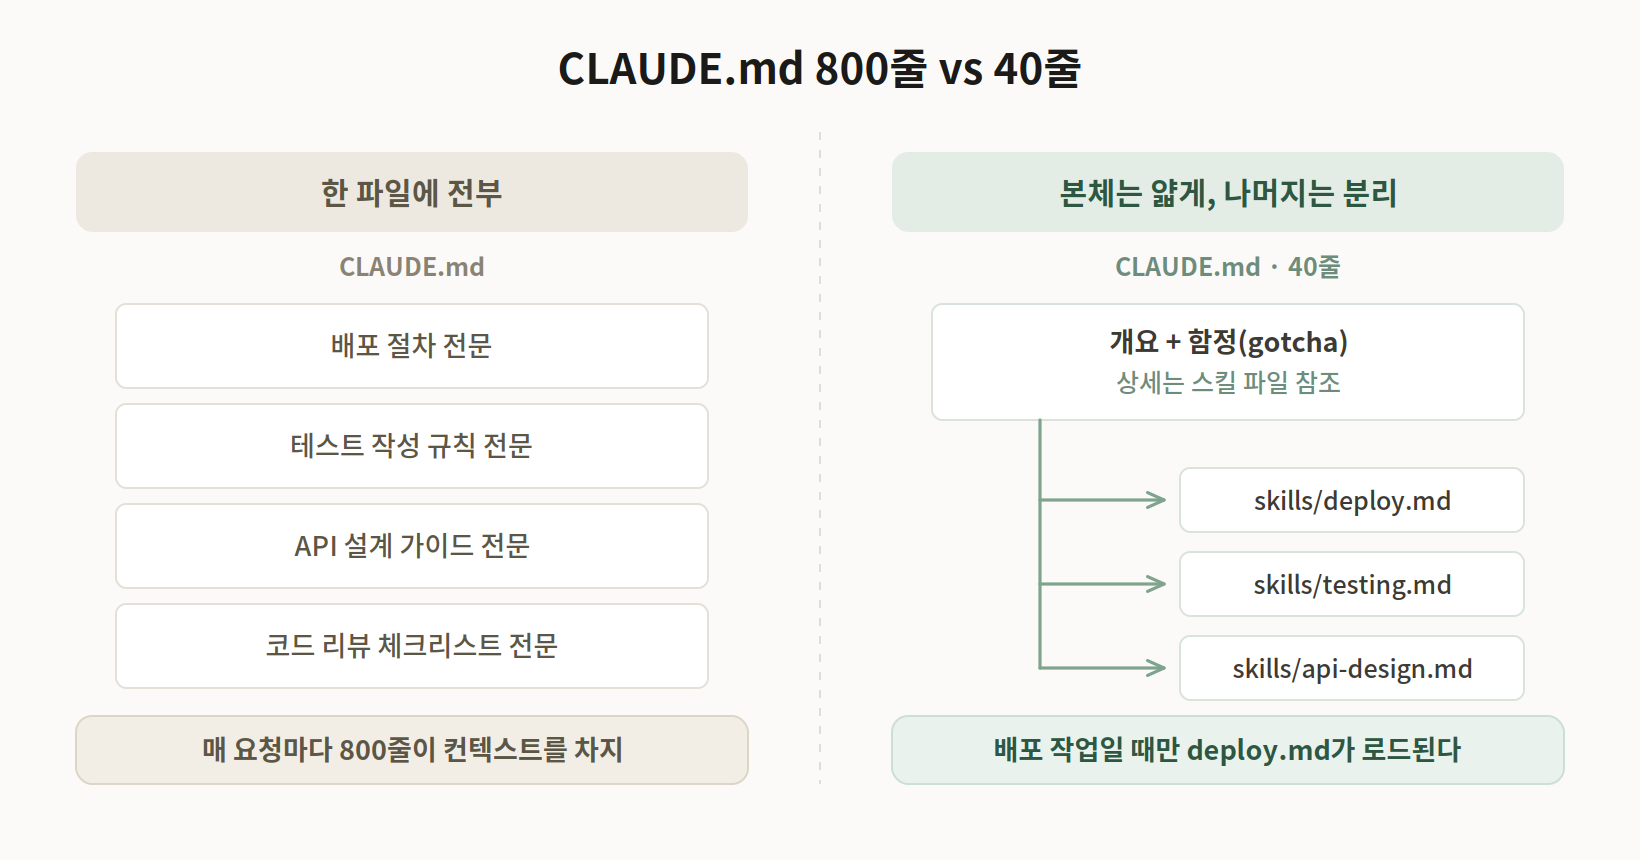
문서는 사정이 조금 다르니 짚고 넘어가야 한다. CLAUDE.md를 @경로 임포트로 쪼개는 건 정리에는 도움이 되지만 임포트된 파일도 시작 시점에 같이 올라온다. 실제로 덜 읽히게 하려면 경로 조건이 붙은 규칙(.claude/rules/ 안에 paths 프런트매터)이나 스킬로 빼야 한다. CLAUDE.md 자체는 길이와 상관없이 통째로 로드되고, 공식 문서가 권하는 목표치는 파일당 200줄 이하다.
4) 반복 → 도구 설명에 위임
옛날에는 중요한 말을 두세 번 써야 했고, 컨텍스트 끝쪽 지시를 더 잘 따르는 경향까지 있었다. 그래서 시스템 프롬프트와 도구 설명에 같은 문장이 나란히 들어갔다. 지금은 지운다. 도구 쓰는 법은 도구 설명에만 쓴다.
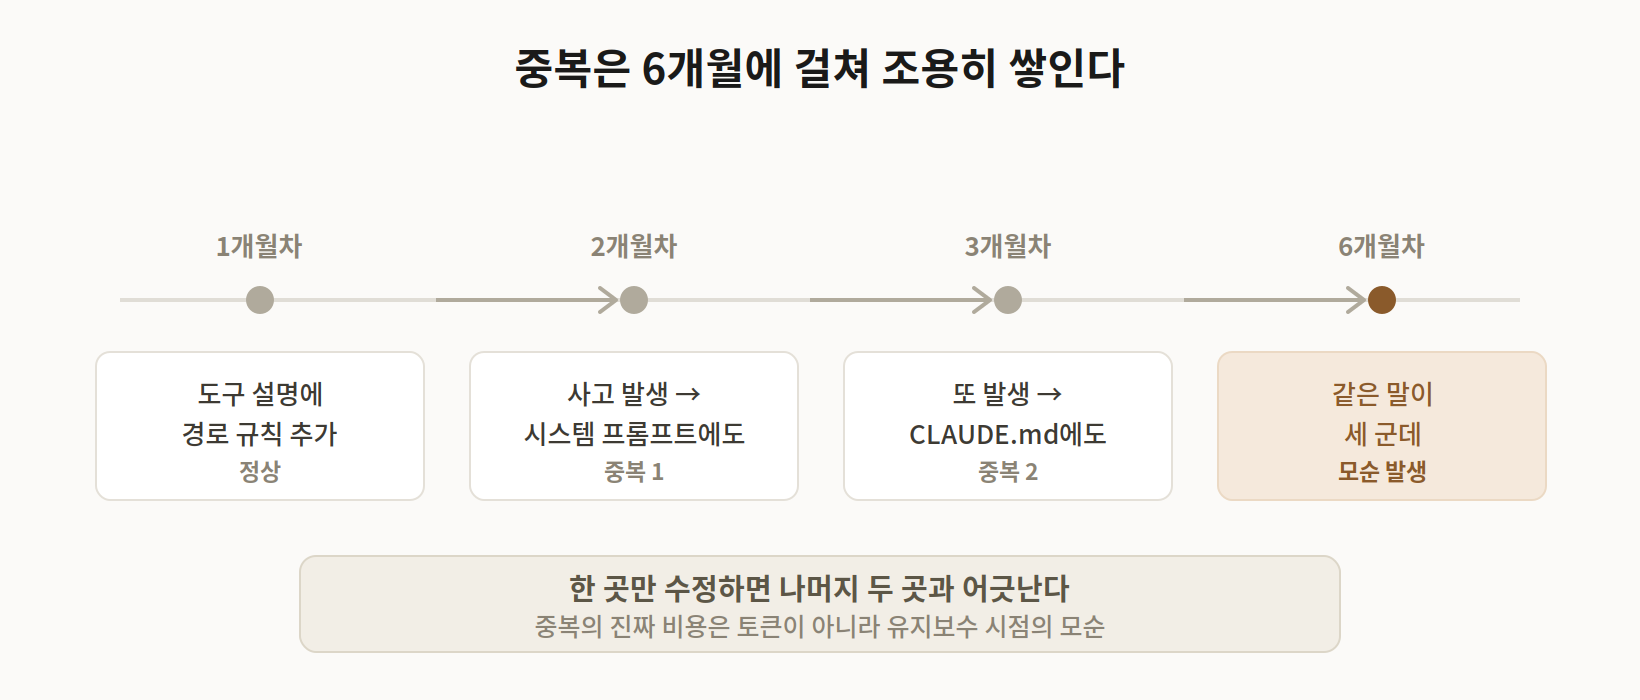
중복이 무서운 건 토큰 때문이 아니라 한쪽만 고쳤을 때다. 두 문장이 다른 말을 하기 시작하면 사람도 어느 쪽이 맞는지 모른다. 서두에 쓴 내 레포 사례가 정확히 이 경우였다.
| 내용 | 위치 |
|---|---|
| 이 도구를 어떻게 쓰는가 | 도구 설명 |
| 이 저장소의 특수 사정 | CLAUDE.md |
| 특정 작업의 절차 | 스킬 파일 |
| 이번 한 번만 필요한 요구 | 사용자 메시지 |
같은 문장이 두 칸에 들어가려 하면 위치를 잘못 잡았다는 신호다.
5) 수동 메모리 → 자동 메모리
기억시킬 것을 CLAUDE.md에 직접 눌러 담던 방식은 자동 메모리로 넘어갔다. 기본으로 켜져 있고, 저장 위치는 ~/.claude/projects/<프로젝트>/memory/, 세션이 시작될 때 MEMORY.md의 앞 200줄(또는 25KB)까지 읽어 들인다.
| CLAUDE.md | 자동 메모리 | |
|---|---|---|
| 소유 | 저장소 (git 커밋) | 사용자 개인 |
| 공유 | 팀 전체 | 공유 안 됨 |
| 성격 | 프로젝트의 사실 | 나의 작업 습관·선호 |
| 예 | "테스트 전 Redis 필요" | "이 사람은 설명을 짧게 선호" |
둘이 헷갈릴 때 쓸 기준은 한 문장이면 된다. 새로 온 팀원에게도 필요한 정보인가?
함정이 하나 있다. 자동 메모리는 머신 로컬이라 같은 저장소를 쓰는 동료에게도, 내 다른 컴퓨터에도 안 간다. 대화 중에만 말한 팀 규칙은 나에게만 쌓인다. (동작은 Claude Code 메모리 공식 문서에서 확인했다.)
6) 단순 스펙 → 풍부한 레퍼런스
요구사항을 마크다운 계획서로만 줄 필요는 없다. 테스트 스위트, HTML 목업, 포팅 대상 코드, "좋은 API 설계란 무엇인가" 같은 취향을 담은 루브릭도 재료가 된다.
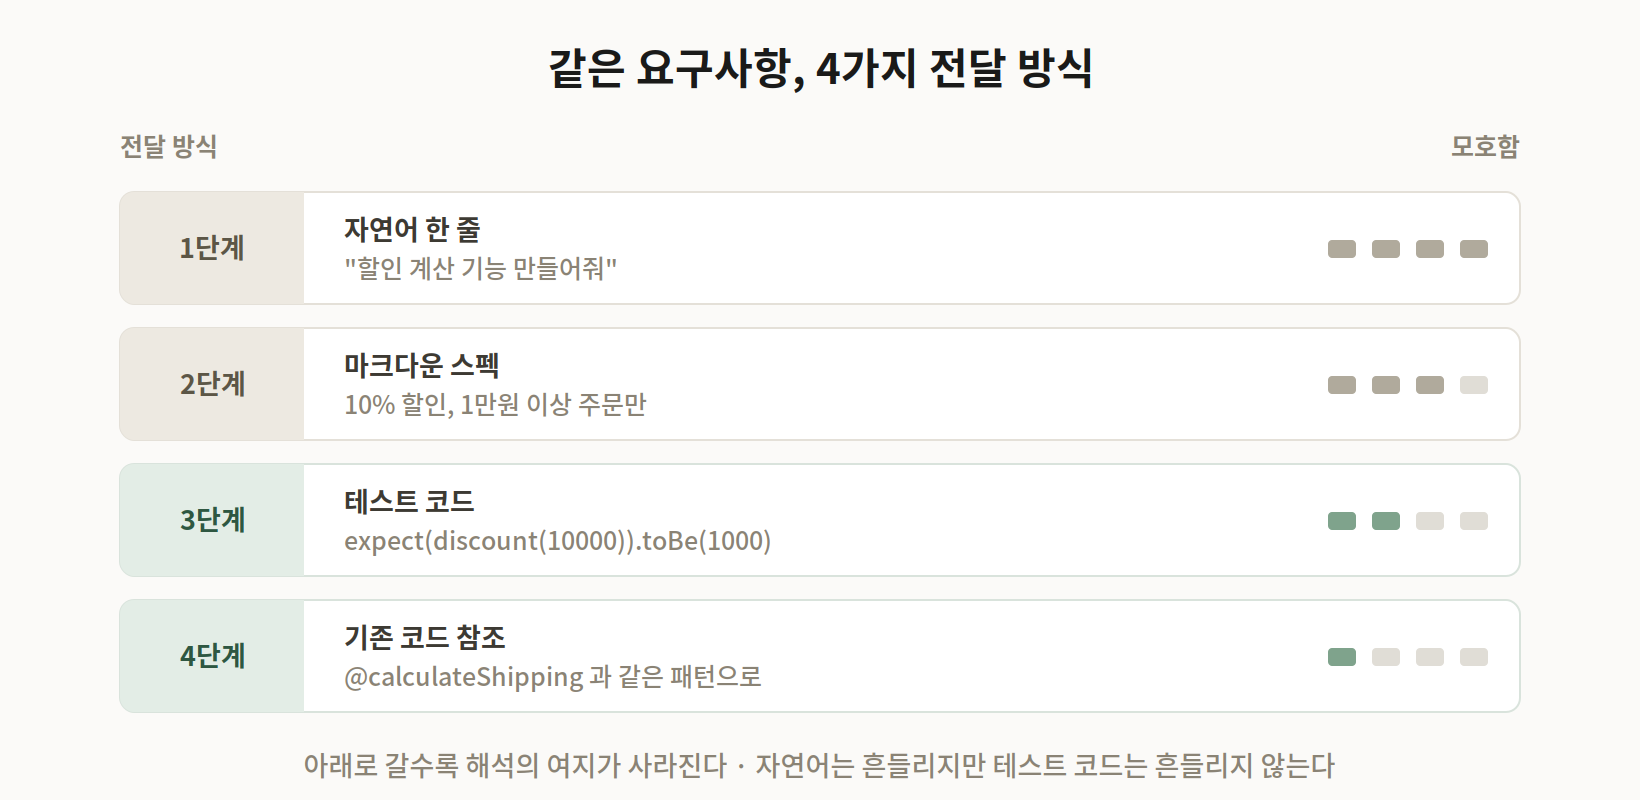
아래로 갈수록 해석의 여지가 줄어든다. 자연어는 읽는 사람마다 다르게 읽히지만 테스트 코드는 통과 아니면 실패다.
△ 스크린샷 첨부 (여백·색상값을 추측해야 한다)
✅ HTML 목업 파일 첨부 (수치가 그대로 들어있다)
어디에 무엇을 쓸 것인가
| 계층 | 역할 | 작성 원칙 |
|---|---|---|
| 시스템 프롬프트 | 제품 맥락 정의 | Claude Code 사용자는 손댈 일 없음. 자체 에이전트를 만든다면 여기에 투자 |
| CLAUDE.md | 저장소 안내 | 설명은 짧게. 토큰 대부분은 함정에 |
| Skills | 필요할 때 찾아 읽는 가이드 | 과도한 제약 금지. 길면 여러 파일로 분할 |
| References | @ 멘션으로 첨부 |
스펙·목업·코드베이스. 코드 형태 우선 |
CLAUDE.md의 원칙은 하나로 줄어든다. 토큰을 함정(gotcha)에 쓴다. 파일 트리를 열면 아는 걸 굳이 문장으로 쓸 이유가 없다.
❌ "src/ 아래에 소스가 있습니다" (파일 트리 보면 안다)
✅ "모든 타입은 types.ts 단일 파일에만 정의" (구조를 봐도 모르는 규칙)
✅ "테스트는 반드시 DB 시드 후 실행" (모르면 실패하는 함정)
CLAUDE.md Before / After
이 프로젝트는 Node.js와 Express로 만든 백엔드 API입니다.
TypeScript를 사용하며 패키지 매니저는 pnpm입니다.
# 코딩 규칙
- 절대 any 타입을 쓰지 마세요
- 주석은 달지 마세요
- 변수명은 camelCase로 하세요
...(이하 40줄 더)
앞 문단은 package.json으로 알 수 있고, 뒤 규칙은 린터가 잡아주거나 상황에 따라 틀린다. 함정 중심으로 다시 쓰면 이렇게 짧아진다.
주문 처리 백엔드. 결제 모듈은 외부 팀 소유이므로 수정 금지.
# 함정 (Gotchas)
- DB 마이그레이션은 반드시 `pnpm db:seed` 이후 실행. 순서를 바꾸면
외래키 제약으로 조용히 실패하고 에러가 안 뜸.
- `src/legacy/` 아래는 자동 포맷 대상 제외. 프리티어 돌리면 diff가 3000줄 남.
- 타입은 `src/types.ts` 단일 파일에만 정의. 다른 곳에 만들면 순환 참조 발생.
# 상세 가이드
- 배포 절차: .claude/skills/deploy.md
줄 수는 3분의 1인데 쓸모는 늘었다. 앞 버전은 읽어도 새로 아는 게 없고, 뒤 버전은 모르면 반드시 한 번 데는 것들만 남았다.
| Before | After | |
|---|---|---|
| 길이 | 60줄+ | 20줄 |
| 내용 | 조사하면 아는 것 | 조사해도 모르는 것 |
| 규칙 | 금지어 나열 | 실패 사례와 원인 |
| 확장 | 계속 덧붙임 | 스킬로 분리 |
그런데 이걸 그대로 따라 하면 안 된다
여기서부터는 원문 요약이 아니라 내 판단이다.
원문은 Anthropic이 자사 최신 세대 모델을 기준으로 쓴 글이다. "규칙을 줄여도 된다"는 결론은 세 전제 위에 서 있다. 모델이 스스로 판단할 능력이 있을 것, 판단이 틀렸을 때의 비용을 감당할 수 있을 것, 결과를 검증할 수단이 있을 것.
전제가 깨지는 자리가 있다. 소형 모델은 판단력에 여유가 없다. 규제 도메인이나 사람 검토 없이 반영되는 자동 배포에서는 한 번의 오판이 비대칭적으로 비싸다. 되돌릴 수 없는 작업과 보안 경계는 지우면 안 된다.
측정도 짚어야 한다. Anthropic이 80%를 지운 근거는 과감함이 아니라 평가 지표였다. "성능 저하가 측정되지 않았다"에서 무게가 실린 쪽은 '측정했다'는 대목이다.
어디까지 어떤 순서로 지워도 되는지, 개인이나 소규모 팀은 어떻게 측정하는지는 2편 — CLAUDE.md 안전하게 줄이는 5단계에서 다룬다.
정리
모델이 좋아질수록 컨텍스트가 할 일은 명령에서 재료 공급 쪽으로 옮겨 간다. 하지 말라고 적는 대신, 판단에 필요한 정보를 제때 주는 편이 낫다.
당장 하나만 손대라면 CLAUDE.md다. 조사해서 알 수 있는 문장을 지우고, 그 자리를 모르면 반드시 한 번 데는 함정으로 채운다.
다만 이 글을 "규칙을 지워라"로 요약하면 절반만 맞다. 되돌릴 수 있는 영역은 판단에 맡기고, 되돌릴 수 없는 영역은 규칙으로 남긴다. 그 경계를 어디에 긋느냐, 그리고 지운 뒤에 무엇을 어떻게 측정하느냐가 2편 — CLAUDE.md 안전하게 줄이는 5단계의 주제다.
'AI 개발 > 컨텍스트 엔지니어링' 카테고리의 다른 글
| [컨텍스트 엔지니어링] compact 뒤에 스킬은 어떻게 되나 (0) | 2026.09.23 |
|---|---|
| [컨텍스트 엔지니어링] 내 CLAUDE.md는 정말 로드되고 있을까 (0) | 2026.07.30 |
| [컨텍스트 엔지니어링] CLAUDE.md 안전하게 줄이는 5단계 (0) | 2026.07.29 |